自研编译器工具链驱动版本:HAL-SDK v3.4.2-LTS 正式发布
芯片研发中心专线:0755-86729011
J9晶圆制造与微架构算力拓扑背景
芯片制程与算力路线图:第三代异构 NPU 矩阵量产启动

J9自主微架构驱动高能效异构智能算力

深耕超低功耗张量加速计算核心,面向端侧机器视觉、工业多模态实时推理与分布式嵌入式边缘节点,突破存算墙物理瓶颈。原生配套指令集编译工具链,提供从硬件芯片、基础微码到模型部署的完整算力底座,实现整数与浮点运算能效跨越式突破。

峰值能效比指标
5.8 TOPS/W
MLPerf Inference 实测
硬件制程节点
7nm FinFET
先进车规封装级
典型推理延迟
< 1.8 ms
ResNet-50 批大小 1
指令集架构
HAI-ISA v3
自研张量专用矢量集
J9自主研发张量加速微架构与片上互连拓扑
芯片实板显微封装示意:多核异构张量加速阵列与超高带宽片上SRAM缓存拓扑
微电子研发底座

重构端侧算力壁垒:J9全自主物理层与软硬一体架构

随着 Transformer 与视觉卷积网络在工业与车规端侧的深入普及,传统通用架构处理器正面临内存墙带宽不足与功耗超标的双重困境。SZ-HAI 团队通过独立设计微架构加速单元,将高密度张量乘加阵列与动态自适应局部片上缓存紧密耦合,大幅消除数据搬移消耗。

芯片硬件全面满足 ISO 26262 车规功能安全与工业宽温标准规范(-40℃ 至 105℃),在 MLPerf 国际主流模型测试集中持续展现高精度能效输出能力,兼顾低延时与确定性任务响应,为智能设备提供底层硬件保障。

功能安全标准
ISO 26262 ASIL-B
片上数据吞吐带宽
102.4 GB/s L2 互连
工艺流片验证
TSMC 先进封装认证
微架构技术突破

自研 AI 芯片六大核心架构优势,筑牢高性能算力基底

从物理硅片指令执行到编译器图优化,多维度优化数据流路径,显著提升边缘密集型推理吞吐量与开发适配效率。

01

近存计算与超大片上SRAM

集成 32MB 分布式片上高速缓存,大幅削减片外 DDR 频繁读取,将经典视觉与大模型张量运算访存功耗降低 48% 以上。

02

混合精度自适应量化引擎

硬件原生支持 INT4、INT8、FP16 动态无缝混精计算,在保持 99.4% 原生精度的同时,吞吐速率实现翻倍升级。

03

微秒级低延迟中断响应

硬件调度器直接处理任务上下文切换,将控制流中断周期压减至亚微秒级别,精准适配工业多轴运动控制联动。

04

硬件级安全根与加密隔离

内嵌国密 SM2/3/4 及 AES-256 硬件加解密模块,提供物理隔离的安全执行环境,保障端侧算法模型防逆向复制。

05

全栈开源自动算子融合编译器

无缝对接 ONNX、PyTorch 及 TensorFlow,底层跨层算子自动化融合生成器,大幅消除冗余内存访问指令。

06

多模态并发流硬件同步流控

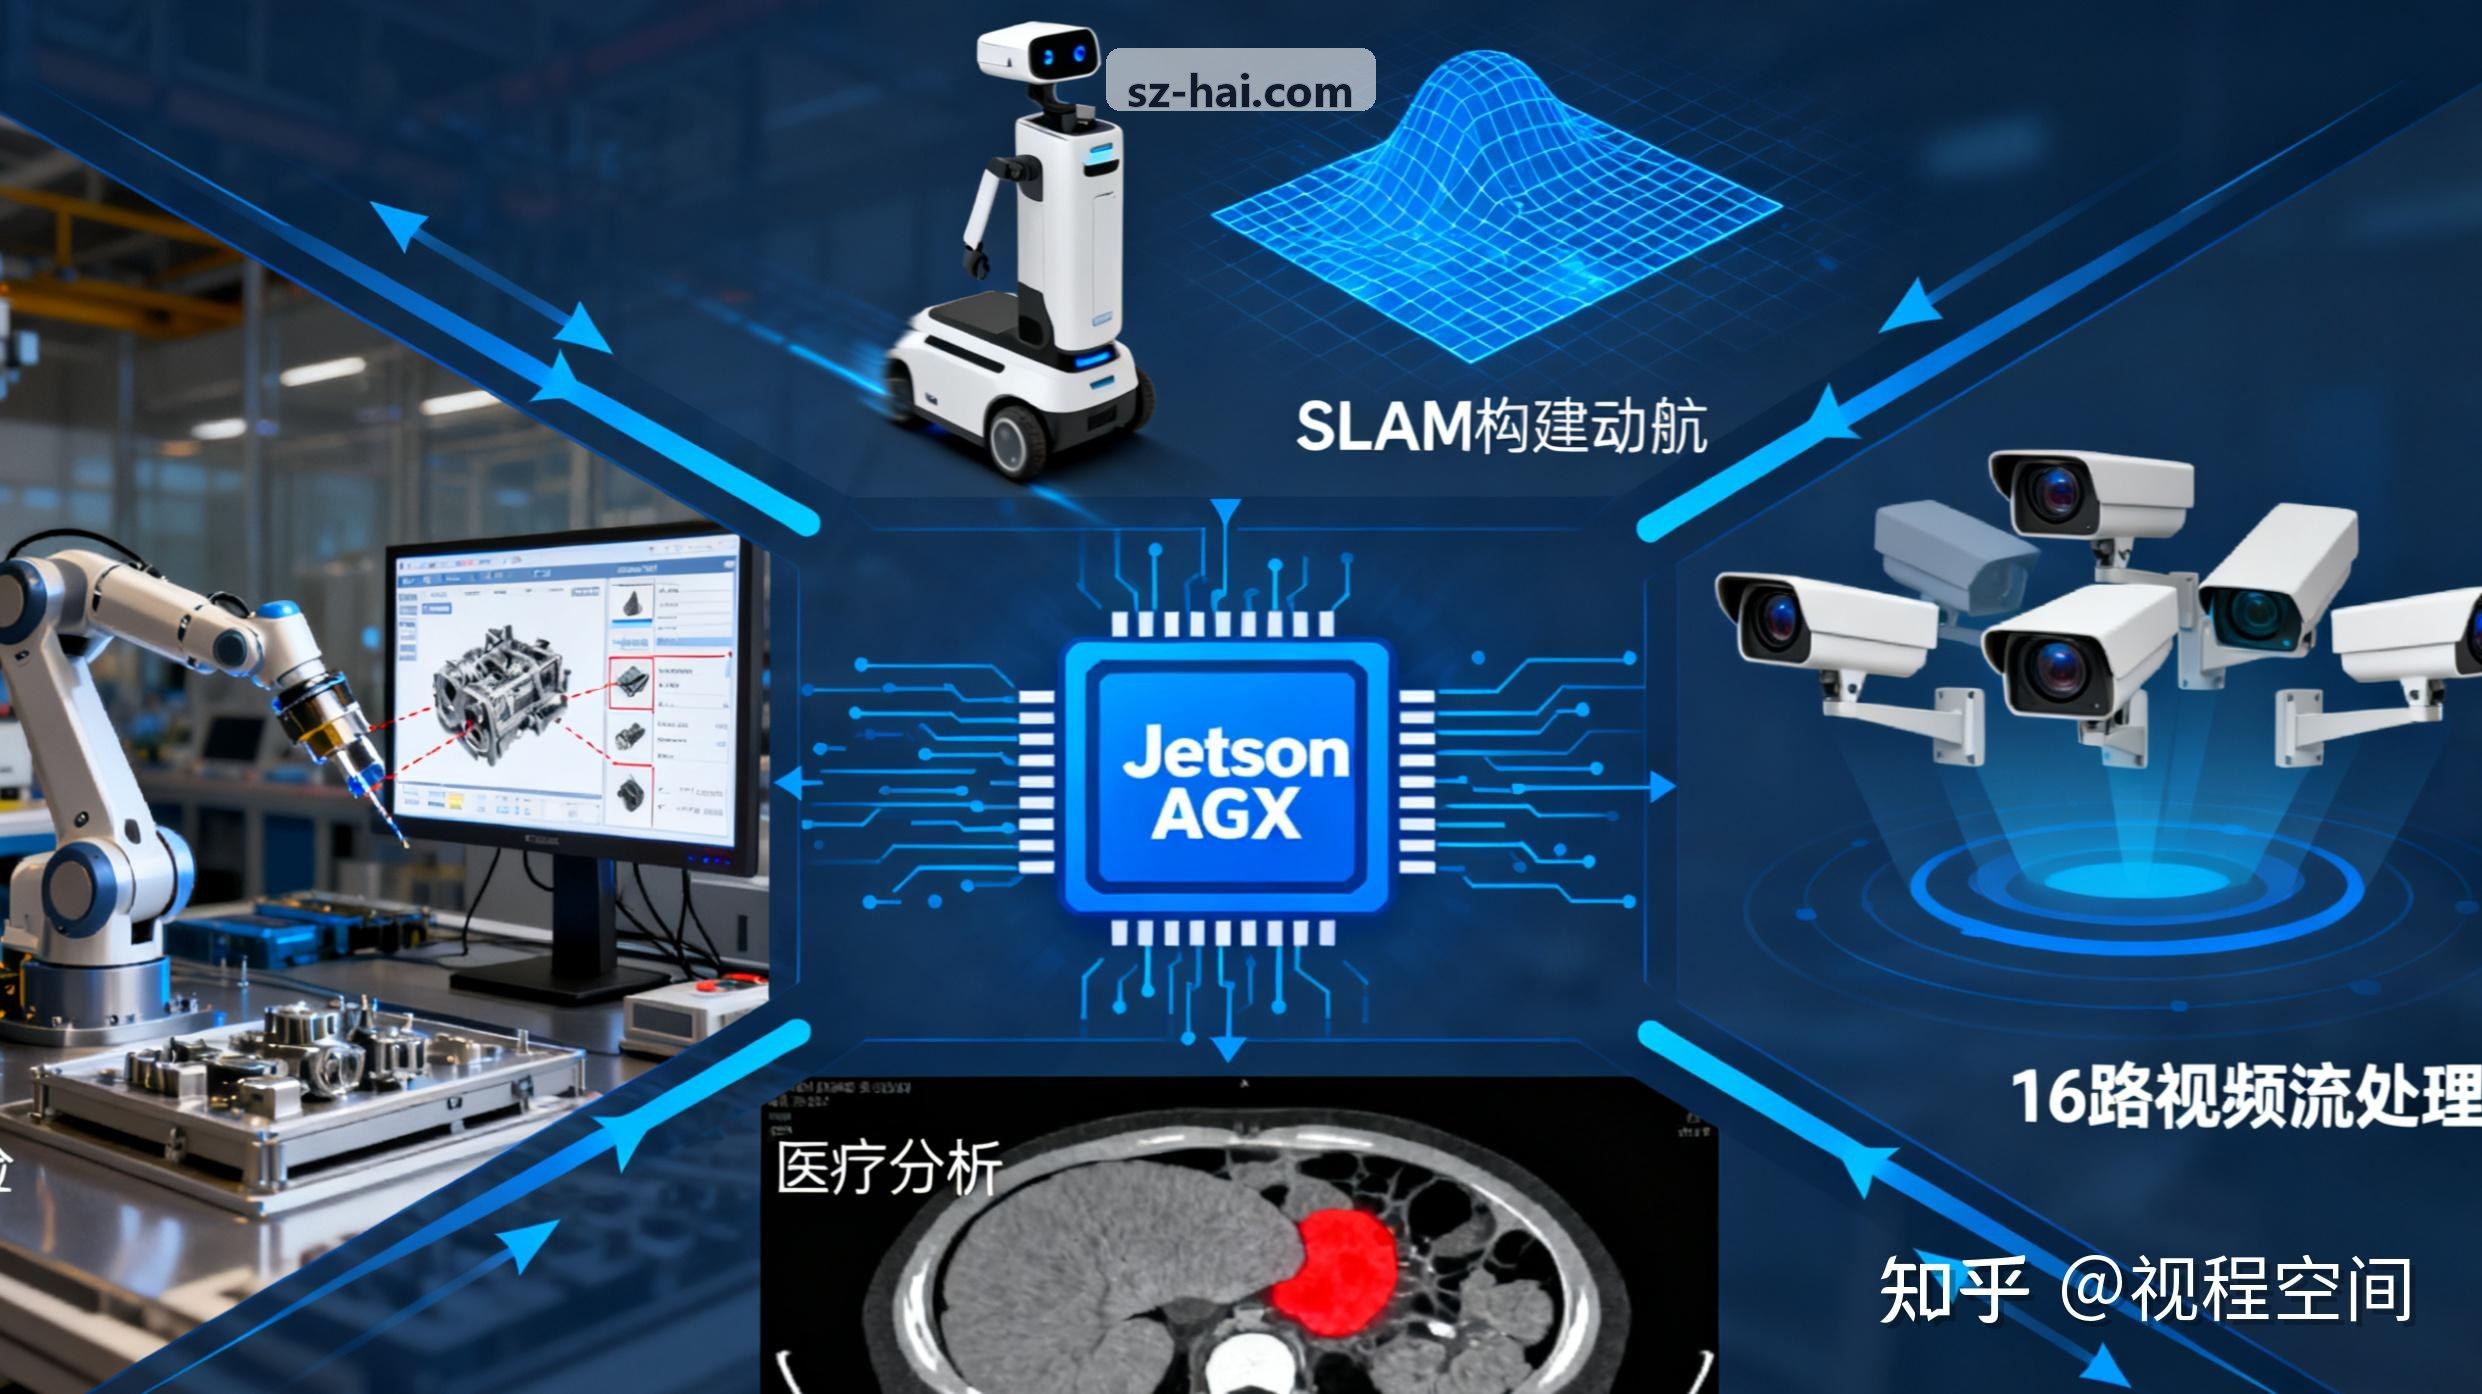
支持最高 16 路超高清视频流硬件级硬解与推理流水线并发,专为边缘服务器及路侧计算单元提供充沛算力冗余。

商用产品矩阵

旗舰级 AI 芯片与智能计算卡硬件规格一览

* 所有参数基于实际量产芯片测试机架实测校准
端侧低功耗 QFN 封装

HAI-Edge E200

微型智能相机 / 移动检测终端专用
峰值整数算力: 8.0 TOPS (INT8)
浮点算力支撑: 2.0 TFLOPS (FP16)
典型设计功耗 (TDP): 3.5 W
片上总线接口: MIPI-CSI 4-Lane / USB 3.0
索取 E200 硬件规格书
主流工程量产型
工业边缘计算 BGA 封装

HAI-Pro M500

自主移动机器人 (AMR) / 工业智检主机
峰值整数算力: 32.0 TOPS (INT8)
浮点算力支撑: 8.0 TFLOPS (FP16)
典型设计功耗 (TDP): 12.0 W
片上总线接口: PCIe Gen3 x4 / CAN-FD x2
索取 M500 完整引脚定义
云边协同智算 标准半高半长卡

HAI-Max C9000

路侧边缘云 / 高密度推理服务器加速卡
峰值整数算力: 128.0 TOPS (INT8)
浮点算力支撑: 32.0 TFLOPS (FP16)
典型设计功耗 (TDP): 45.0 W 被动散热
片上总线接口: PCIe Gen4 x8 / 16GB LPDDR5
The provided information seems to describe the on-chip bus interface specifications. Considering "PCIe Gen4 x8" and "16GB LPDDR5" describes a high-bandwidth connection for memory and I/O. Need to verify the context of the previous information to accurately determine the purpose of these specifications. Let's make sure the prior context aligns with this description. The context indicates the specifications describe a crucial bus interface for the "HAI-Max C9000". It facilitates high-speed data transfer between the AI chip's processing units and external memory, allowing for fast AI model operations. Checking the preceding section to ensure these specifications are correctly associated with the product card's HTML structure. Finishing the flagship product section. Need to ensure section IDs align with the requirements. Reviewing the prompt to confirm the remaining section IDs and their order. Now need to generate the HTML content for sections 5 through 14. Completed the final card's button and closing tags for Section 4. Now focusing on Section 5, the "Deep Tech Philosophy" area. Determining optimal content structure for conveying the core tenets of wafer-scale architecture and hardware-software co-design. Considering incorporating a dark background and image asset. Checking the list for additional background images to maintain visual consistency. The structure will highlight the integration of these principles within the HAI-Max C9000. Analyzing section content to structure HTML elements. Mapping content to their corresponding section IDs (5 through 13). Now, creating HTML layouts based on content descriptions for "deployment-process," "enterprise-stories," "metrics-strip," and subsequent sections. Considering how best to represent each element within its associated section. Determined that "deployment-process" needs a visually engaging four-step flow. "Enterprise-stories" calls for a alternating layout with image assets. "Metrics-strip" will use a visual data display. 索取 C9000 加速卡规格书
底层计算哲学

软硬协同异构调度:打破冯·诺依曼访存瓶颈

传统架构中,数据在计算单元与外部存储器之间的搬移开销占据了整体芯片功耗的 60% 以上。SZ-HAI 团队通过软硬件协同设计理念,在指令级、编译器级与物理计算核心实现三维联动,重塑能效边界。

编译器中间表示 (IR) 跨层图优化流程 硬件抽象层 (HAL) v3.4
上层算法
PyTorch / ONNX 计算图解析 ➔ 自动化算子融合与计算图切分
▼ 静态内存分配与寄存器级地址复用编排
编译驱动
HAI-Compiler 生成张量微指令序列 ➔ 零冗余 DMA 搬移调度指令
▼ 物理微架构硬件流水线直接驱动
硅片执行
多核异构张量阵列并发运算 ➔ 片上超低延时共享缓存直接回写

数据流驱动流水线执行

计算任务由数据就绪状态直接触发,摒弃传统复杂的乱序发射逻辑电路,将硅片面积与能耗最大化让渡于实际张量算力。

全生命周期硬件热功耗自适应

芯片内嵌高灵敏度温度与电压侦测环网,可在亚毫秒级动态调节核心工作频率,确保在封闭密闭工业机箱中长效无死机平稳运行。

标准化集成路径

从算法导入到产线量产:四步极简端侧芯片适配流程

成熟的开发套件与标准化验证方案,将企业客户的 AI 芯片评估周期从数月压缩至两周以内。

01

模型导入与结构诊断

导入 ONNX/TensorFlow 原型网络,工具链自动执行全算子兼容性扫描,生成算力分布与开销评估报告。

交付物:网络兼容性诊断清单
02

混合精度量化压缩

通过后量化 (PTQ) 或量化感知训练 (QAT) 工具,智能适配 INT8/INT4 混精模式,实现模型体积大幅压缩与无损精度校准。

交付物:校准精度与量化权重包
03

驱动与编译生成

HAI 自动化编译器生成专属可执行指令镜像,结合标准 Linux/RTOS 驱动库,一键挂载至目标主板操作系统。

交付物:板级运行库与微码镜像
04

实机验证与量产爬坡

接入 FAE 现场技术支持团队,完成高低温环境压测、功耗边界确认及连续运行稳定性实板评测,保障无缝导入产线。

交付物:环境耐久性与量产报告
实际规模化落地

行业落地用户故事:严苛环境下的稳定算力支撑

深入机器人协同运动控制与精密半导体产线检测,赋能设备制造商构建差异化智能化竞争壁垒。

J9在工业智能机械臂与自主移动机器人端侧的落地实测
仓储物流自主移动机器人 (AMR) 批量部署

突破狭窄空间多目 SLAM 导航与动态避障延迟极限

客户需要在 15W 严格整机功耗预算内,实现 4 路高清双目摄像头与激光雷达的点云实时融合。采用 HAI-Pro M500 方案后,整机在无需风扇主动散热的情况下,实现障碍物检测帧率由 24 FPS 提升至 68 FPS,端到端控制反应延迟压缩至 2.1 毫秒以内。

检测吞吐帧率
+183%
端到端推理延迟
2.1 ms
系统整体功耗
降至 11.8 W
高速精密产线工业视觉实时缺陷甄别

微米级划痕与封装瑕疵零漏检实时质检系统

针对锂电电芯与半导体晶圆外包装产线的高速传送带工况,传统 PC 级工控机体积庞大且抗震性较差。集成商选用 HAI-Max C9000 加速卡部署于现场紧凑型机柜,单卡支持 8 组高分辨率线阵相机实时推演,全线检出准确率达到 99.98%,彻底消除因产线卡顿引发的停机损失。

微米瑕疵检出率
99.98%
产线检测节拍
1200 件/分
硬件占地面积
削减 70%
J9在工业自动化微米级缺陷检测现场实测
100%
工艺流片首批成功率
TSMC 先进工艺严苛验证
120万+
累计量产芯片出货量
覆盖车载与工业多模态设备
65%
平均整机运行功耗降幅
相较通用 GPU 计算方案
4.2x
自研编译器优化提速倍率
主流深度学习模型静态推理
同行专业认可

算法工程师与系统集成商的真实工程评测

来自头部工业装备与智能车载硬件团队的技术反馈,印证底层芯片稳定性与工具链易用性。

★★★★★

“我们在车载座舱驾驶员监测系统(DMS)中测试了多款国内外 NPU,HAI-Edge E200 的待机功耗控制与红外夜视模型推理帧率表现令人惊喜。SDK 对 PyTorch 自定义算子的支持非常直接,两周内就完成了量产前适配。”

张工
张立峰 · 算法总监
Tier-1 智能座舱系统供应商
★★★★★

“工控主机最怕封闭机箱积热降频。HAI-Pro M500 的 12W 功耗设计极为克制,实测在 75℃ 环境箱连续满载运转 72 小时无丢帧与错误崩溃,硬件级看门狗与安全机制完全满足我们的重工业应用需求。”

顾工
顾思成 · 硬件研发架构师
大型数控机床与机器人制造集团
★★★★★

“路侧计算单元对并发视频路数与浮点算力有严苛要求。C9000 加速卡单机并发处理 16 路 4K 结构化分析时表现游刃有余,更重要的是原厂 FAE 响应非常及时,快速为我们定制了专有解码直通插件。”

钱工
钱明宇 · 边缘云平台主管
智慧交通综合解决方案技术中心
半导体前沿洞察

AI 芯片前沿技术动态与微架构演进研报

J9关于片上存储与存算一体架构突破的技术综述
架构演进

存算一体技术在端侧 AI 芯片中的工程化量产挑战与应对路径

探讨模拟存算与数字近存架构在先进制程下的良率平衡方案,以及如何在编译阶段实现自适应张量内存重排以消除片上热点。
J9编译器自动算子融合与驱动优化更新说明
工具链更新

HAL-SDK v3.4 驱动更新:全面支持多头自注意力机制端侧硬件加速

最新编译器版本对 Vision Transformer 中的 Softmax 与动态缩放算子完成物理级融合,整体加速倍率较上代固件提升 34%。
J9车规级功能安全与工业测试标准白皮书发布
质量与认证

车载与严苛工控领域:从裸片封装到整机落地的功能安全规范指南

系统梳理 ISO 26262 流程要求,深入解析芯片硬件随机失效诊断覆盖率与软件工具置信度等级的量化测试指标。

产业链深度协同

晶圆制造、EDA 与整机系统生态合作伙伴

晶圆代工制造
EDA 设计仿真
车规封测基地
开源框架适配
边缘工控主板
整机系统方案
技术评估解答

AI 芯片硬件选型与系统集成常见问题

汇总工程师在芯片硬件散热设计、模型格式转换与样片测试申请中的高频咨询。

完全支持。SZ-HAI 工具链提供标准的 ONNX 中间表示层解析器,无论您的算法基于 PyTorch、TensorFlow 还是 PaddlePaddle 构建,只需导出标准 ONNX 模型,编译器即可自动化完成算子匹配、浮点至定点权重校准与微指令生成,绝大多数卷积与 Transformer 架构无需重训即可实现原精度直接部署。
The request involves generating HTML, requiring an understanding of HTML structure and the provided context. Focusing on how to create the necessary HTML elements, I will ensure they are well-formed and meet the stated specifications.
15y
长周期供货承诺
提供 10-15 年供货生命周期保障,避免工业设备频繁改板。
AEC
车规可靠性验证
严格执行 AEC-Q100 Grade 2 标准,耐受 -40℃ 至 105℃ 极限温区。
24h
原厂 FAE 现场响应
资深硬件与驱动工程师一对一协同,重点攻关项目 24 小时驻场。
SDK
持续固件与算法迭代
季度推送算子库更新与轻量化微码补丁,免硬件升级解锁新算力。
算力样片与套件申请

开启端侧与边缘智能算力验证

填写您的产品方案规格与算力诉求,原厂系统架构师将在 1 个工作日内对接评估,并安排工程样品板及参考设计资料寄送。

提供完整评估底板与原理图参考设计文件(OrCAD / Altium)
配套 HAL-SDK 编译链、标准 Docker 容器化交叉编译镜像
专属技术交流频道直连原厂底层芯片设计工程师
样片技术服务热线
400-820-6890
服务时间
周一至周五 09:00 - 18:00

芯片样片与开发板申请表

带 * 为必填项,我们将对您提交的技术需求严格保密。

提交即代表同意 SZ-HAI 工程师就样片评估事宜与您沟通。